
Onderzoek van Peec AI: wat 37.804 AI-antwoorden ons leren over prompttracking
Traditioneel gezien hebben we een redelijk beeld van short-tail keywords die in Google gebruikt worden. Bij ChatGPT of Gemini formuleert elke gebruiker zijn eigen vraag, in zijn eigen woorden, met zijn eigen context. Dat voelt als een oneindige ruimte die je onmogelijk kunt monitoren.
Nieuw onderzoek van Peec AI, gepubliceerd op Search Engine Journal, laat zien dat die ruimte veel minder chaotisch is dan het lijkt.
Wat er onderzocht is
Peec AI draaide twee parallelle studies over vijf AI-engines: ChatGPT, Gemini, Perplexity, Google AI Mode en AI Overviews.
| Studie A | Studie B | |
|---|---|---|
| Bron prompts | 288 door mensen geschreven prompts uit de dataset van Rand Fishkin (SparkToro) | 54 basisprompts uit 18 verticals |
| Aantal chats | 17.000+ | 20.000+ |
| Doel | Hoe verschillend prompten mensen echt? | Wat is het effect van kleine wijzigingen? |
In totaal: 1.754 prompts en 37.804 AI-antwoorden, verdeeld over vijf sectoren en 18 subverticals. Elke prompt is meerdere keren gedraaid om de natuurlijke ruis van LLM’s uit te beperken.
De methode draait om cosine similarity. Elke prompt wordt omgezet naar een semantische embedding, waarna je de betekenisafstand tussen twee prompts kunt uitdrukken in een getal tussen 0 en 1.
Bevinding 1: mensen prompten minder verschillend dan je denkt
Op het oog schrijft iedereen iets anders. Wiskundig gezien valt dit mee:
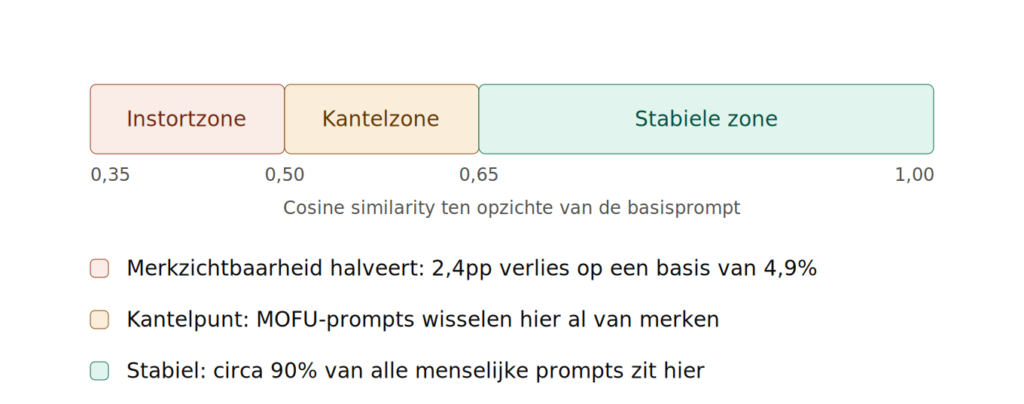
- Ongeveer 88 tot 92% van alle promptparen zit boven een cosine similarity van 0,50.
- Ongeveer 95% zit boven 0,40.
- Minder dan 10% van de variaties dwaalt semantisch echt af.
Twee embeddingmodellen lieten hetzelfde patroon zien. Mensen kiezen andere woorden voor dezelfde behoefte, maar komen bijna altijd op hetzelfde punt uit.
Bevinding 2: er is een drempelwaarde, en die ligt laag
De gemiddelde kans dat een willekeurig merk genoemd wordt in een antwoord ligt op 4,9%. Zolang een variant boven de 0,50 tot 0,60 similarity blijft (afhankelijk van de engine) blijft die zichtbaarheid stabiel. Je merk verschijnt bij dezelfde prompts, met ongeveer dezelfde frequentie.
Zakt een prompt door naar de laagste bucket (0,35 tot 0,39), dan daalt de zichtbaarheid met 2,40 procentpunt. Dat is bijna een halvering.
Bevinding 3: stijl doet er net zoveel toe als betekenis
Wat je vraagt is maar de helft. Hoe je het vraagt, verandert wat het model laat zien.
| Promptkenmerk | Effect op aantal genoemde merken |
|---|---|
| Vraagt om ranking, lijst, tabel of vergelijking | Tot +20% meer merkvermeldingen |
| Korte keyword-stijl (“beste CRM klein bedrijf 2026”) | Tot +25% meer merkvermeldingen |
| Persona-prompt (“Jij bent een IT-consultant…”) | Minder merkvermeldingen: verbreedt naar educatieve antwoorden |
| Extra lengte, filler, conversationele woorden | Geen meetbaar effect |
| Constraints (budget, features) in ChatGPT en Perplexity | Minder merken in het antwoord |
| Constraints in Gemini en AI Overviews | Meer merken, waarschijnlijk via extra fanout-queries |
Bevinding 4: het midden van de funnel is waar het gebeurt
Woordkeuze telt niet overal even zwaar:
- Top of funnel zoals “Wat is een CRM?” is stabiel. Kleine verschillen in formulering veranderen nauwelijks welke merken verschijnen.
- Middle of funnel zoals “beste CRM voor een klein remote team” is uiterst gevoelig. Hier zie je al significante verschuivingen in de 0,60 tot 0,65-bucket.
- Bottom of funnel lijkt stabiel, maar dat is schijnstabiliteit. Alles hangt om de merknaam heen, dus er valt weinig te verschuiven.
De aanbeveling uit het onderzoek: verdeel je trackingvolume ongeveer als 25% TOFU, 50% MOFU, 25% BOFU.
Bevinding 5: engines gedragen zich niet hetzelfde
De richting van het effect is overal gelijk, de hevigheid niet.
- Gemini: het effect dooft het snelst uit, geconcentreerd in de laagste buckets.
- Google AI Overviews: de meest hardnekkige MOFU-gevoeligheid van alle engines.
- ChatGPT, Perplexity, Google AI Mode: een breder bereik. Bij ChatGPT begint het merkverlies zodra de formulering onder de 0,60 tot 0,64-bucket zakt.
Wat dit betekent voor SEO en GEO
1. Keyword research wordt intentie-clustering. Je hoeft niet elke formulering te tracken. Wel elke intentie plus context. Dat sluit dichter aan bij hoe we al met topic clusters werken dan bij een klassieke keywordlijst.
2. Contentformat wordt een zichtbaarheidsfactor. Als lijst- en vergelijkingsprompts meer merken oproepen, is het aannemelijk dat lijst- en vergelijkingscontent makkelijker geciteerd wordt.
3. Rapporteer per engine. Een samengestelde “AI visibility score” verbergt of een daling een marktverschuiving is of een eigenaardigheid van één model.
4. Meng geen promptstijlen in één rapportage. Een lijstprompt en een open vraag starten niet op dezelfde lijn. Tag je prompts op format, anders vergelijk je appels met peren.
Wat je in de praktijk hoort te doen: bepaal de intenties die er commercieel toe doen, kies per intentie een ankerprompt die klinkt zoals je doelgroep écht praat, segmenteer op funnelfase, houd promptstijlen gescheiden en lees elke engine apart.
